你的小龙虾超级笔记来啦
实现效果
一句话总结:这篇文章教你实现下面所有
- 完全免费、开源的笔记软件
- 支持网页端、安卓版、苹果端
- 数据完全掌握在自己手中
- 按自己的意愿实现定制(个性化)
在上一篇文章中,我和大家分享了在云端部署小龙虾的过程。其实我还有个长期存在的痛点:作为知识管理的重度爱好者,我一直在探索这类工具的最佳解决方案——此前在公众号里,我也推荐过好几款知识管理、笔记管理相关的软件。这些软件既有云端的SaaS服务,也有本地离线版本。随着科技的发展,随时随地记录笔记越来越方便:很多软件支持语音录入,录入完成后能自动转文字,还能添加标签;后续查找时,直接通过对话就能获取结果。
不过这种方式有个明显问题:数据会被应用厂商深度绑定。需要取回数据时,往往面临较大限制——部分软件直接限制导出(私有格式),有些虽允许导出,但设置了导出频率等限制。从软件厂商角度看其设计的初衷是让用户在自身软件内使用,不希望用户离开。因此,在知识管理领域,把数据掌握在自己手中至关重要。
之前我推荐过开源笔记应用memos,用容器技术能轻松部署,其数据库基于Sqlite3存储,完全由自己掌控。安卓、苹果、网页端都支持,录入也很方便。我甚至为它开发过脚本,能把数据生成到本地,能够和另一款笔记软件协同使用——感兴趣的话可以查看:
最近大模型技术+小龙虾越来越强大,我找到了更好用的使用方式。
小龙虾支持多种接入方式,比如微信就能实现与自己的小龙虾对话。大模型能将语音转文字,并生成到笔记软件中。相比其他商用软件,它有个独特优势:其他笔记软件中,大模型会根据输入内容自动添加标签;而作为知识管理者,我已经有一套成熟的标签体系,因此可以在对话中添加自定义提示词,比如优先复用已有标签,避免大模型“自作主张”。甚至还能在提示词里定义笔记样式。
下面我把整个实践过程分享出来,感兴趣的朋友可以直接参考。
配置说明(总共就这几步)
- 安装小龙虾(或其他各种虾)并配置微信接入+一键部署usememos
- 让小龙虾自己装skill usememos-api 并定制你的个性化规则
- 在微信中语音输入后就自动生成笔记啦
-----我的个性化笔记skill----
Tag 使用规则
预定义 Tag 列表
创建 memos 时,优先从以下预定义 tag 中选取:
diary software ……规则说明
- 优先使用现有 tag - 根据内容从预定义列表中匹配相关 tag
- 避免新增 tag - 尽量不创建列表中不存在的 tag,如果和规则匹配不上的,就使用 #todo
- 自动提取 - Memos 会自动将
#tag格式的内容提取为标签
Tag 详细说明
| Tag | 用途 | 示例关键词 |
|---|---|---|
diary |
和个人日记相关 | 日记、每日记录、心情 |
software |
软件相关 | 软件、App、工具 |
idea |
名人警句类 | 警句、名言、座右铭 |
rethink |
个人反思类 | 反思、复盘 |
bak |
一些临时的备份 | 备份、临时 |
resource |
收集整理的资源 | 引用数据、理论 |
kid |
和孩子相关 | 孩子、教育 |
career |
和职业发展相关 | 职场、职业规划 |
health |
和个人健康相关 | 健康、身体 |
todo |
暂时不明确的内容 | 待办、稍后处理 |
pkm |
个人知识管理相关 | PKM、知识管理 |
mac |
苹果Mac平台相关内容 | Mac、苹果电脑 |
python |
Python相关 | Python、库、算法、代码 |
note |
笔记相关 | 笔记 |
it |
IT相关 | IT、信息技术 |
brain |
大脑相关 | 大脑、思维 |
psychology |
心理、心理学相关 | 心理、心理学 |
reading |
阅读相关 | 阅读 |
ai |
人工智能相关 | AI、人工智能 |
win |
Windows平台相关 | Windows |
mind |
个人思维相关 | 思维、思考 |
nas |
网络存储NAS相关 | NAS、存储 |
tour |
旅游相关 | 旅游、旅行 |
grow |
个人成长相关 | 成长 |
book |
书籍相关 | 书籍、书 |
poem |
诗词相关 | 诗词、诗 |
logseq |
笔记软件logseq相关 | Logseq |
hr |
人力资源相关 | HR、人力资源 |
innovation |
创新相关 | 创新 |
pic |
图片相关 | 图片、截图 |
cost |
成本相关 | 成本、花费 |
hobby |
兴趣相关 | 兴趣、爱好 |
scrum |
敏捷scrum相关 | Scrum、敏捷 |
tool |
工具类 | 工具 |
示例
| 内容场景 | 建议 Tag |
|---|---|
| 每日记录、心情 | #diary |
| 知识管理、个人知识库 | #pkm |
| 软件开发、代码 | #software #python |
| 读书笔记 | #reading #book |
| 职业发展 | #career |
| AI相关 | #ai |
| 苹果/Mac相关 | #mac |
| 心理健康 | #health #psychology |
| Windows相关 | #win |
| 个人成长 | #grow |
| 生活反思 | #life #rethink |
注意事项
- 不要新增 tag,如果不确定使用 #todo
- 保持 tag 简洁,单词最佳
- 善用组合:
#note #ai #pkm
创建 Memo 前的文本预处理规则
在将内容保存为 memo 之前,必须对输入文本进行预处理。
核心原则
规则一:修正拼写错误
必须修正所有因语音识别导致的明显错别字和同音字。
常见错误示例:
| 错误 | 修正 |
|---|---|
| "今天舔起" | "今天天气" |
| "我要一零零个" | "我要100个" |
| "辨论" | "辩论" |
| "己经" | "已经" |
数字处理:语音输入的数字识别错误(如"一零零"→"100"),应统一为阿拉伯数字或根据上下文选择合适形式。
规则二:精简语气词
删除无意义的语气词:
- "嗯"、"啊"、"呃"、"这个这个"等
规则三:处理重复词汇
语音输入时可能出现卡顿导致的词汇重复:
| 错误 | 修正 |
|---|---|
| "我我觉得" | "我觉得" |
| "这个这个问题" | "这个问题" |
| "非常非常" | "非常" |
规则四:进行简单润色
- 调整语序或补充省略部分,使句子通顺自然,但不改变原意。
- 不添加多余信息,不改变说话风格。
- 务必要遵守Memo 格式规则
规则五:保留专有名词和术语
不要"纠正"以下内容:
- 专有名词、品牌名
- 人名、地名
- 技术术语
- 中英文混合表达
示例:
| 内容 | 处理 |
|---|---|
| "iPhone" | 保持不变 |
| "Python" | 保持不变 |
| "AI" | 保持不变 |
| "OKR" | 保持不变 |
预处理流程
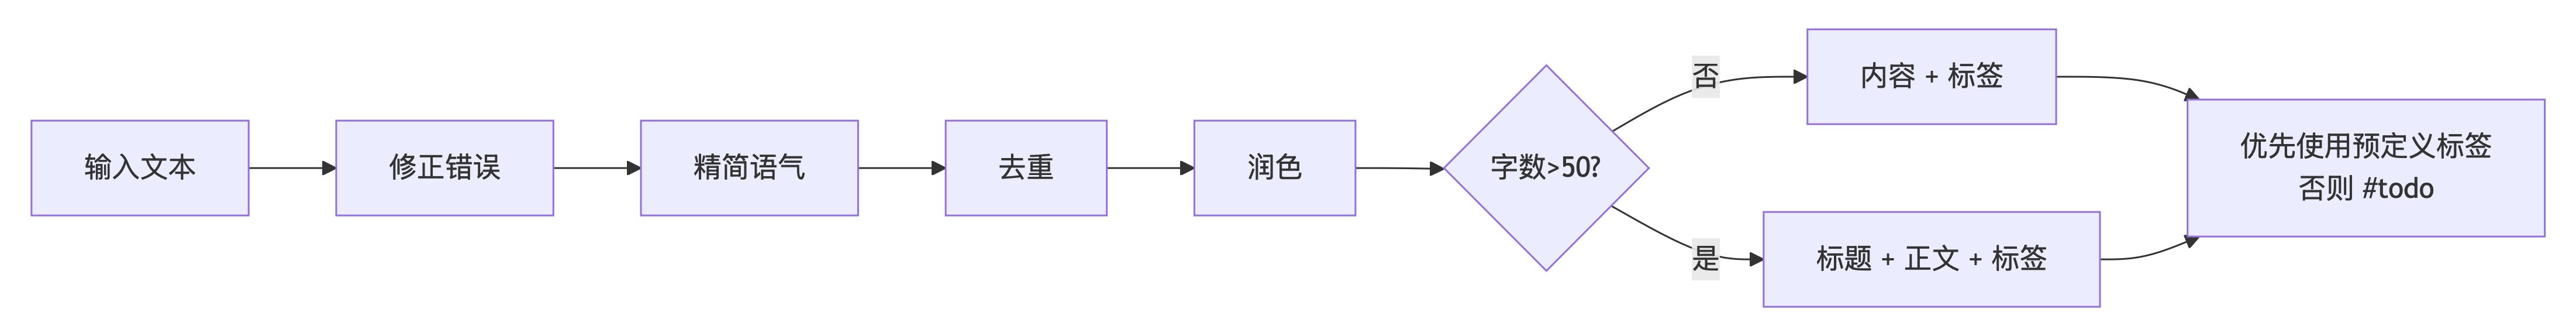
输入文本 → 修正拼写错误 → 精简语气词 → 处理重复词汇 → 简单润色 → 添加标签 → 保存示例对比
| 原始输入 | 预处理后 |
|---|---|
| "今天舔起怎么样啊我觉得还还行吧" | "今天天气怎么样?我觉得还挺行。" |
| "这个这个Python编程语言嗯很好用" | "这个Python编程语言很好用。" |
| "我要一零零个苹果" | "我要100个苹果。" |
| "我觉得AI太好了非常非常好用" | "我觉得AI太好了,非常好用。" |
Memo 格式规则
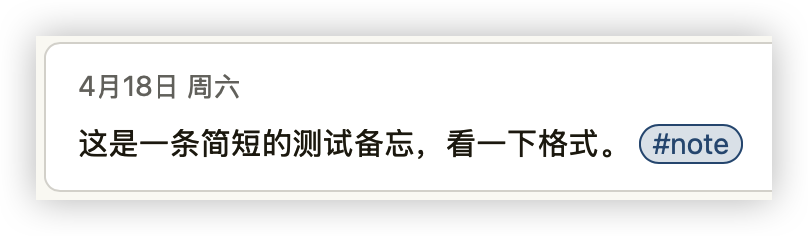
短内容格式(≤50汉字)
当输入内容较短(≤50个汉字)时,使用简洁格式:
格式:
内容 #标签示例:
《工作的心智》这本书提出了一个重要观点,在职场中要有自己独立的作品。 #idea长内容格式(>50汉字)
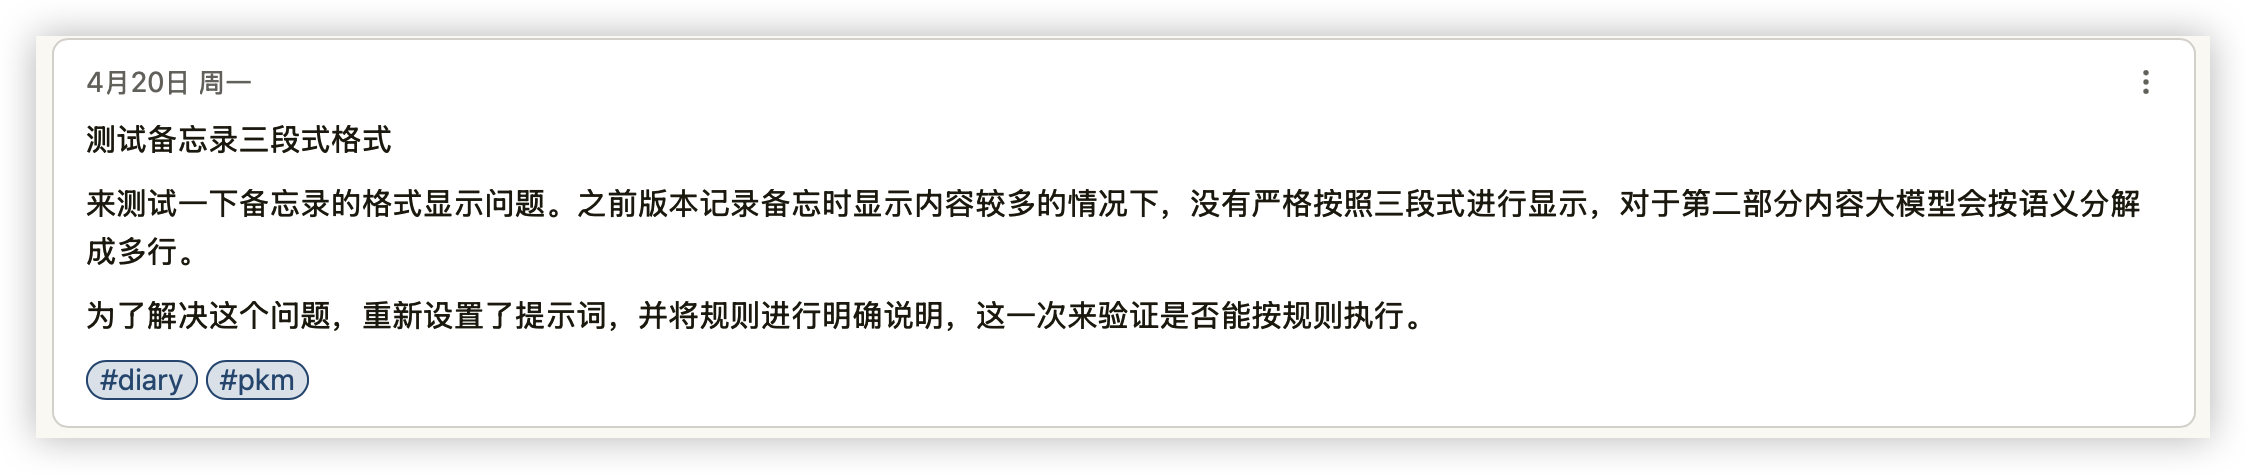
当输入内容较长(>50个汉字)时,使用三段式格式:
格式:
第一行:一句话概括
第二行:详细正文内容(此部分不要换行显示,所有正文保持在一行内)
末尾:#标签1 #标签2 ...结构说明:
| 部分 | 说明 |
|---|---|
| 第一部分 | 对memos进行一句话概括(简短标题) |
| 第二部分 | memo的详细内容 |
| 第三部分 | 标签,多个标签用空格分隔,尽可能使用英文标签 |
示例:
教育孩子的前提是家长自身要得到成长
在《我们的孩子为什么放不下手机》这本杂志当中提到了一个观点,孩子放下手机不光孩子自身的问题,更多的是需要家长们一起投入和改变。书中讲到了一个具体案例,当孩子在婴幼儿时期哭闹时,多数家长习惯性的反应是把天线宝宝的视频播放给孩子看,这种安抚手段看似立竿见影,殊不知当家长习惯了这种模式之后,孩子逐渐地也形成了这样的条件反射,那就是当他自己哭闹的时候会得到视频。这种反馈一旦形成就会持续不断地进行强化,从而加剧了孩子对视频的成瘾。
#note #kid
格式判断标准
| 条件 | 格式 |
|---|---|
| ≤50个汉字 | 简短格式(内容 + 空格 + 标签) |
| >50个汉字 | 三段式(标题 + 内容 + 标签) |
注意事项
- 标签位置:标签始终在内容末尾
- 标签数量:通常1-2个标签最佳
- 中文标点:使用中文标点符号
- 标签选择:优先从预定义列表中选取英文标签
- 格式要求:三段式中标题占一行,正文占一行(不要将正文分多行),标签占一行。